
Agentic Rollout
Agentic rollout 将已有 agent app (harness) 接入 Relax 训练。Relax 为每个 Session 启动并管理一个 agent process, 由该 process 运行原有 harness。Relax 记录已提交的 conversation,并把选中的 context 转换为训练 sample。
当您已经有一个通过 OpenAI-compatible Chat Completions API 调用模型的 agent application (harness) 时, Agentic rollout 尤其适合将其接入 Relax。使用 OpenAI Responses 或 Anthropic Messages 的 agent 也可以接入。 Agent 既可以 standalone 运行,也可以由集中式平台统一执行。
推荐工作流
评估和接入 agent app (harness)、检查启动配置或开展实验时,建议使用仓库 skills/agentic-rollout/ 下的 agentic-rollout skill。该 skill 会检查当前 checkout,并按阶段检查 context topology、parser、export 与 credit、 timeout、并发容量和 runtime 证据。实验仍需用户明确授权;本文继续说明 model API 请求与响应格式、API 和 export 契约。
手动阅读时:
- 从已有 agent 开始:先读准备 Agent,再读用户接入。
- Multi-agent training、导出多个 context 或定义 per-context credit: 选择训练 Context 与 Credit。
- 调整并发或跨 step 执行:配置 Runtime 行为。
- 理解 SessionForest 与调度原理:理解 Agentic Rollout 原理。
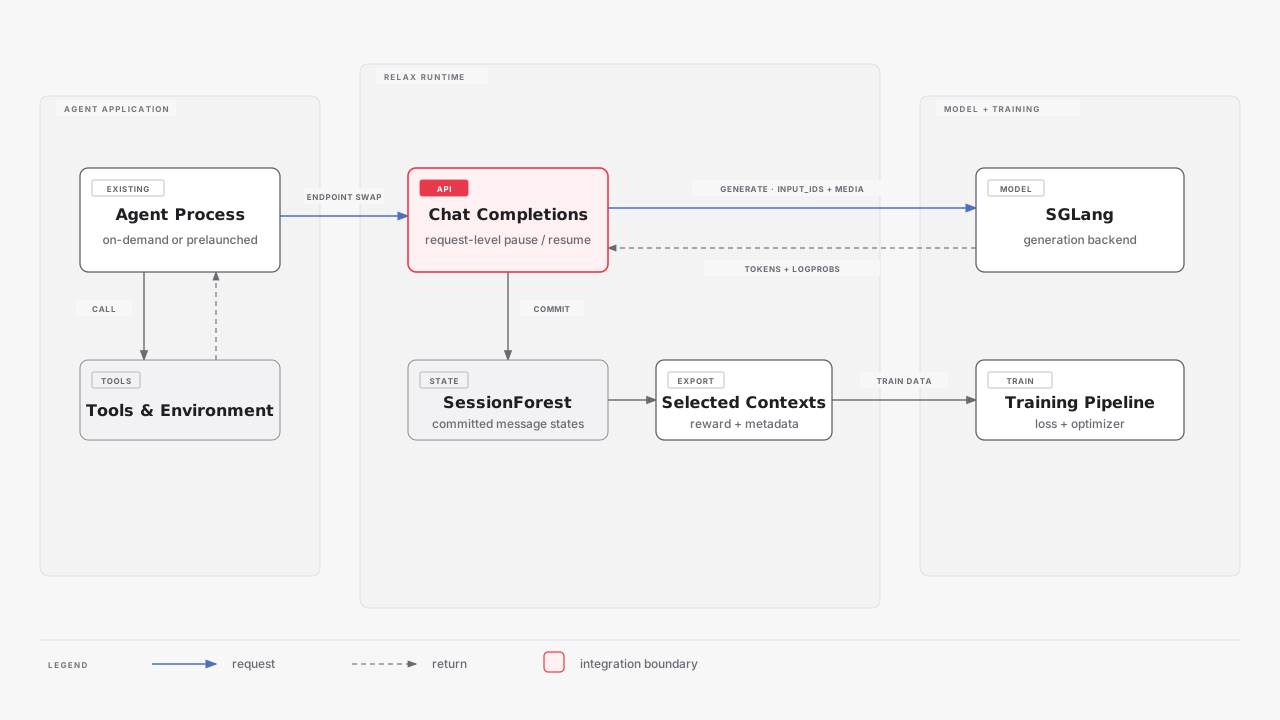
核心能力
用已有 agent 做 Agentic RL 通过 Chat Completions、Responses 或 Messages endpoint 接入已有 agent app (harness),并连接到 Relax 训练。
Agent process warmup 在 rollout 执行前提前启动 agent process,隐藏进程启动、tool setup 和环境初始化耗时。
Request-level partial rollout 无需修改 agent,即可跨 rollout step 中断并恢复 model generation。
准备 Agent
先让 agent 在 Relax 外独立运行,使用它原有的 task input 和 model endpoint。继续接入前,确认 agent 能够:
- 通过原有输入接口接收一个真实任务;
- 调用一个受支持的 model endpoint;
- 完成一次完整的 harness 运行,需要时包含多个 turn;
- 写出最终结果;
- 正常退出,不产生错误。
Task input、model endpoint、API credential 和 result output 都应支持配置。接入后 harness 的行为保持不变; Relax 在其外围提供新的 input、endpoint 和 output boundary。
Relax 为每个 Session 启动一个进程作为 agent 的入口。这个进程可以直接运行 agent、启动子进程,或把任务提交到 其他机器或集中式平台。Agent 在哪里运行没有影响,只要请求能到达 RELAX_BASE_URL。这个进程持续运行到任务 结束,然后退出。
远程集中式 Agent 平台
如果您的 agent 并非在本地直接运行,而是提交到远程平台集中运行,并且远程平台带有 agent 并发限制,则启动前 必须阅读配置 Runtime 行为。
用户接入
Dataset 与 Session Input
Relax 把每个任务写入 RELAX_INPUT_JSON 指向的文件。文件可以包含 messages、metadata,或同时包含两者。 下面的例子直接提供可用的 messages:
{
  "messages": [
    {"role": "system", "content": "You are a helpful research assistant."},
    {"role": "user", "content": "Which city hosted the event?"}
  ],
  "metadata": {
    "task_id": "example-001"
  }
}
Text 与 Message Input
标准 dataset 路径把 --input-key 映射到 messages。String 会转换成一条 user message;message list 保持 OpenAI message 结构。
Metadata-Only Task
--metadata-key 把 dataset object 映射到 metadata。Harness 可以在运行时读取 metadata,并现场组装 messages。
Multimodal Input
继续使用 Relax 原有 Dataset 格式
图片数据继续按照 Relax 其他 multimodal training 的方式准备:在 prompt 或 message content 中放置 <image> 占位符,把 image path、URL 或 binary value 保存在独立 dataset field 中,再用 --multimodal-keys 建立映射。 Agentic rollout 会在 agent process 读取前,自动把该输入转换成 OpenAI image_url 格式。
例如,dataset row 可以继续使用普通 Relax 格式:
{
  "input": [{"role": "user", "content": "<image>Describe this image."}],
  "images": ["/path/to/image.png"]
}
把 image modality 映射到 dataset field:
--multimodal-keys '{"image":"images"}'images 中的每张图片都需要一个对应的 <image> 占位符。标准 Relax data path 会把占位符与 image value 结合, 并生成内部 image item。Agentic rollout 随后增加 process-boundary 转换,将其变成 OpenAI image_url。Dataset 本身无需保存 image_url object。Placeholder 与 field mapping 路径仅用于 dataset 生成的初始输入。
| 阶段 | 图片处理 |
|---|---|
| 标准 Relax dataset 路径 | --multimodal-keys 把 dataset image 插入 prompt,并提取 model media input |
| Agentic Session Input | Process 启动前,Relax 把内部 image item 转换为 OpenAI image_url content |
| Agent model request | Relax 读取 image_url,为 SGLang 准备 backend media,并构造 processor-expanded training input |
在 process boundary,已有的 data:image/...、http:// 或 https:// URL 会保持原样。Local path、byte payload 或 内存中的 image 会被加载、转换成 RGB PNG,并编码为 data URI。
messages 中的图片使用 OpenAI image_url content 格式:
{
  "role": "user",
  "content": [
    {"type": "image_url", "image_url": {"url": "data:image/png;base64,<base64-data>"}},
    {"type": "text", "text": "Describe this image."}
  ]
}
初始 dataset image 会自动转换成该格式。Agent 在后续 turn 中新增图片时,直接在 messages 中追加相同的 image_url content;后续 observation 不经过 dataset placeholder 或 --multimodal-keys。Tool observation 同样 可以包含 image_url item。完整的 multi-turn 实现可参考 examples/deepeyes_agentic/app/env_deepeyes.py;inference 与 training token 视图参见 Token-in, Token-out。
最小 Agent Application
下面的 application 接收可直接使用的 messages,调用一次 model,并导出最终 conversation。基于 metadata 的 harness 可以先读取 metadata,再组装 messages。实际 agent 可以保留原有 tool loop,并用同一个 client 发起更多请求。
import asyncio
import json
import os
from pathlib import Path

from openai import AsyncOpenAI


async def main() -> None:
    session_input = json.loads(Path(os.environ["RELAX_INPUT_JSON"]).read_text(encoding="utf-8"))
    messages = session_input["messages"]

    client = AsyncOpenAI(
        base_url=os.environ["RELAX_BASE_URL"],
        api_key=os.environ["RELAX_SESSION_ID"],
        timeout=9999,
    )
    response = await client.chat.completions.create(
        model="model",
        messages=messages,
    )
    messages.append(response.choices[0].message.model_dump())

    output = {
        "metadata": {"task_success": 1.0},
        "reward": 1.0,
    }
    Path(os.environ["RELAX_OUTPUT_JSON"]).write_text(
        json.dumps(output, ensure_ascii=False),
        encoding="utf-8",
    )


asyncio.run(main())
上面的 timeout=9999 是 agent 向 RELAX_BASE_URL 发起单次 model request 的 wall-clock timeout。Prelaunch、 partial rollout 的 abort/resume 或 fully async 执行可能会 hold 住同一个 request,因此 client timeout 需要覆盖 最长的等待时间。
使用 model_dump() 保存完整 assistant message。Reasoning content 与 tool call 才能参与后续 turn 和 SessionForest matching。
Model API
Relax 接收 Chat Completions request,以及下文列出的 Responses 和 Messages request 结构。三者使用相同的 generation 与 SessionForest core。每个 endpoint 都使用 Authorization: Bearer <RELAX_SESSION_ID> 鉴权。
| Interface | Endpoint | 完整 history 字段 | Turn limit |
|---|---|---|---|
| OpenAI Chat Completions | /v1/chat/completions | messages | max_completion_tokens,或旧版 max_tokens |
| OpenAI Responses | /v1/responses | typed input Items | max_output_tokens |
| Anthropic Messages | /v1/messages | system 与 messages | 必填 max_tokens |
不使用标准 client 时
标准 client 应原样接收 RELAX_BASE_URL,由 client 自动追加 resource path。自行发送 HTTP request 时,使用 RELAX_BASE_URL.rstrip("/") + endpoint,其中 endpoint 取自上表。拼接时需要保留已有 service path;部分 URL helper 会把前导 / 解析到 origin 根路径,从而丢弃 /agentic_api。
当前 API 限制
Model request 必须通过 HTTP 发送。省略 stream 或设为 false 时返回 JSON;stream=true 使用 Buffered SSE, 并在完整 generation 结束后发送 model-content events。当前不支持 WebSocket 和 token-level streaming。每条 request 都必须重放所属 conversation branch 的完整 history。Responses request 必须包含完整 input; Relax 不使用 previous_response_id。
Relax 把三种 interface 的 request 规范化为 canonical messages、function tools 和 chat_template_kwargs,再用 该 state 完成 SessionForest matching 与 generation。API response 按当前 request 使用的 interface 返回。model 字段会回显到 response,但不选择 Relax inference backend。下表之外的 request field 不会改变 generation。
Chat Completions
训练配置提供 temperature 和 top_p。Request 中的这两个字段会被忽略。
| 字段 | 行为 |
|---|---|
messages | 必需;一个 conversation branch 的完整 history |
tools | 该 branch 使用的 tool definitions |
chat_template_kwargs | 该 branch 使用的 template arguments |
max_completion_tokens | 当前 turn 的最大 generated token 数 |
max_tokens | max_completion_tokens 的旧版别名;同时设置时优先使用新字段 |
stop | 当前 turn 的 stop string 或 list |
seed | 当前 turn 的 sampling seed |
logprobs | 在 response 中返回 generated-token logprobs |
Chat Completions message 契约
Message role 使用 user、assistant、tool 或 system。User、system 与 tool message 需要非空 content;tool 返回 None 或 "" 时,使用稳定的非空表示。Assistant 包含 tool call 或 reasoning 时可以省略文本 content。Harness 发送 Chat developer message 时,需要在 harness 侧转换为 system。add_generation_prompt、tokenize 与 tools 由 Relax 管理,请勿在 request chat_template_kwargs 中设置。
使用了 tools 或 chat_template_kwargs 的 request 必须持续传入这些字段。模型和 chat template 需要时,配置 --agentic-reasoning-parser 和 --agentic-tool-call-parser。
Responses
Relax 投影以下 typed input Items:
| Item | 投影结果 |
|---|---|
Top-level instructions string | 放在 input 之前的 canonical system message |
带 user、assistant、system 或 developer role 的 message | Canonical message;developer 转换为 system |
input_text / output_text | Message text |
带 image_url string 的 user input_image | Canonical image_url content |
summary 或 content 中带可读文本的 reasoning | Assistant reasoning_content |
function_call | 保持同一 call_id 的 assistant function tool call |
带 text output 的 function_call_output | 保持同一 call_id 的 tool message |
Responses function tool 使用扁平的 type、name、parameters 和可选 description 结构。输出 reasoning、 assistant text 与 function call 会变成相应 Responses Item。function_call_output 接受 string 或 input_text block。因长度限制结束的结果使用 status: "incomplete";其他成功结果使用 status: "completed"。
Anthropic Messages
Relax 投影以下 Messages block:
| Block | 投影结果 |
|---|---|
system string 或 text block | Canonical system message |
User 或 assistant text | Canonical message text |
带 URL 或 base64 source 的 user image | Canonical image_url content |
Assistant thinking | Assistant reasoning_content |
Assistant tool_use | 保持同一 ID 的 assistant function tool call |
带 text content 的 user tool_result | 保持同一 tool-use ID 的 tool message |
Messages tool 使用 name、input_schema 和可选 description;省略 tool type 或设置 type: "custom" 时, 会投影为 canonical function tool。Anthropic response 使用 text、thinking 和 tool-use block,并提供 Anthropic stop reason。 stop_sequences 会作为当前 turn 的 stop string 传给 generation。
Buffered SSE
Buffered SSE 会在完整 generation 执行期间保持 HTTP request 打开。Relax 先发送 connection frame;generation 等待期间每 15 秒发送一次 heartbeat。完成后,Relax 把当前协议的完整 terminal event sequence 一起发出, 不会暴露 token-by-token delta。
| 协议 | Terminal sequence |
|---|---|
| Chat Completions | 一个带 usage 的完整 chat.completion.chunk,随后是 [DONE];失败时发送 OpenAI error data 和 [DONE] |
| Responses | response.created、每个 output Item 对应一个 response.output_item.done,随后是 response.completed、response.incomplete 或 response.failed |
| Messages | message_start、完整 content-block events、message_delta,随后是 message_stop;失败时使用 event: error |
Chat 与 Responses 使用 SSE comment 作为 connection 和 heartbeat frame。Messages 使用 event: ping。JSON 与 Buffered SSE 共享 normalized request、generation、SessionForest commit、usage accounting 和 finish reason。每个 成功的 Chat terminal chunk 都包含完整 usage,不依赖 stream_options.include_usage;Relax 不会额外发送 usage chunk。
Agent Process Contract
Relax 向每个 agent process 注入:
| 变量 | 含义 |
|---|---|
RELAX_INPUT_JSON | Session input JSON path |
RELAX_OUTPUT_JSON | Session output path |
RELAX_SESSION_IO_DIR | Per-session 临时目录 |
RELAX_BASE_URL | Agentic model API base URL |
RELAX_SESSION_ID | Session ID 与 API credential |
RELAX_ROLLOUT_MODE | train 或 eval |
RELAX_GROUP_ID | Runtime Group ID |
RELAX_ 前缀由 Relax 保留。Shell launcher 可以把这些值映射到 application 已有接口:
#!/usr/bin/env bash

export OPENAI_BASE_URL="${RELAX_BASE_URL}"
export OPENAI_API_KEY="${RELAX_SESSION_ID}"

python -m my_agent \
    --input-json "${RELAX_INPUT_JSON}" \
    --output-json "${RELAX_OUTPUT_JSON}"
Relax 会管理 launcher 创建的 process group。Shell wrapper 可以使用 exec 简化 process tree,但 exec 不是 必须条件。Application 配置通过 --agent-env 传入:
--agent-env FOO=bar BAZ=qux启动训练
在可运行的 Relax 训练命令中加入:
--use-agentic-rollout \
--agent-cwd /path/to/agent_repo \
--agent-command "bash run_agent_app.sh"
Model、dataset、parallelism 和 algorithm 配置可参考 examples/ 下的完整 recipe。
验证第一个 Rollout
第一个 rollout step 完成时,日志中会出现 accounting_end:
AGENTIC ROLLOUT event=accounting_end rollout=0 ...Progress bar 使用 scored 表示已完成的 session。把最终 conversation 导出为一个训练 context 的 application 至此已经可以训练。
选择训练 Context 与 Credit
| 每个 session 导出的 Context 数量 | 必需的训练 Credit |
|---|---|
| 一个 context | 写入 reward,或省略并配置 --custom-rm-path |
| 多个 context | 配置 --agentic-custom-advantage-path;一般不鼓励 custom RM,使用前需要明确审查 Group RM |
导出最终 Conversation
导出一个最终训练 context 时,可以不创建 RELAX_OUTPUT_JSON、写入空文件,或写入包含可选 metadata 与 reward 的 object。Relax 会导出唯一的 committed conversation context。Output 不包含 reward 时,训练命令 必须配置 --custom-rm-path。
{
  "metadata": {"task_success": 1.0},
  "reward": 1.0
}
隐式导出仅用于经过审查的严格线性历史。任何非线性历史都必须显式导出,即使当前只有一个 exportable leaf。
显式导出一个或多个 Context
Multi-agent training 是显式导出的常见场景。例如,一个 session 可以导出一个 main context 和多个 searcher context,使它们分别获得训练 credit。单个 agent 存在多个 conversation branch 时,也可以使用显式导出。每条 JSONL record 表示一个训练 context,而不是一个 agent process。导出多个 context 时必须配置 --agentic-custom-advantage-path。
每个选中用于训练的 context 写一条 JSONL record:
{"name":"main","messages":[{"role":"user","content":"..."},{"role":"assistant","content":"..."}],"metadata":{"role":"main","outcome":1.0},"reward":1.0}
{"name":"searcher_0","messages":[{"role":"user","content":"..."},{"role":"assistant","content":"..."}],"metadata":{"role":"searcher","outcome":1.0}}
{"name":"searcher_1","messages":[{"role":"user","content":"..."},{"role":"assistant","content":"..."}],"metadata":{"role":"searcher","outcome":1.0}}| 字段 | 是否必需 | 含义 |
|---|---|---|
name | 是 | Session 内唯一的非空名称,同时作为 custom advantage key |
messages | 是 | Generation 实际使用的完整 message history |
tools | 使用时必需 | 该 context 使用的准确 tools |
chat_template_kwargs | 使用时必需 | 该 context 使用的准确 template arguments |
metadata | 否 | Per-context metric 与 custom credit 输入 |
reward | 否 | Per-context 任务 outcome,可以是 number、object 或 null |
每条 record 必须匹配一个 committed SessionForest state。完整保留 generation 使用的 assistant message、reasoning content、tool call、tools 与 template arguments。Relax 训练 JSONL 中出现的 record;未写入的 context 不参与训练。
即使 agent 调用 Responses 或 Messages,显式 export record 仍使用上文 canonical Chat-shaped messages、嵌套 function tools 和 chat_template_kwargs。请复用能够匹配 committed SessionForest state 的 normalized value; raw Responses input list 或 Anthropic block list 不是显式 export record。
Context 数量与 process 数量无关。一个 process 可以导出多个 context。Multi-agent application 可以导出一个或 多个 context。Eval 可以仅导出 main,training 则可以导出更多 context。
Standard Reward
每个 session 导出一个 context 时支持 standard reward。可以在 output 中写入 reward;也可以省略 reward,并 配置 --custom-rm-path。Numeric reward 表示 scalar outcome。Reward object 可以同时保存 primary reward 与 numeric helper metric。使用 reward object 时配置:
--reward-key <primary-key>用 Custom Advantage 分配 Multi-Agent Credit
一个 session 导出多个 context 后,单个任务 outcome 无法说明每个 context 应获得多少训练 credit。Custom advantage 把 export metadata 转换成每个 context 的一个数值。
函数需要的所有输入都应写入每个 export 的 metadata,然后配置:
--agentic-custom-advantage-path my_package.advantage.advantage_func假设第一个 sampled session 向 RELAX_OUTPUT_JSON 写入以下显式 record:
{"name":"main","messages":[{"role":"user","content":"..."},{"role":"assistant","content":"..."}],"metadata":{"outcome":1.0},"reward":1.0}
{"name":"searcher_0","messages":[{"role":"user","content":"..."},{"role":"assistant","content":"..."}],"metadata":{"usefulness":0.6}}
再假设第二个 sampled session 导出相同 name,outcome=0.0,usefulness=0.2。
Relax 直接根据前面导出的 context 构造函数输入:
- 每个 export 的
name成为 mapping key; - 该 export 最终的 metadata 成为 mapping value;
- 外层 list 保持 sampled Group 中的 session 顺序。
该 mapping 仅传入 export metadata。函数签名为:
from typing import Any


def advantage_func(
    metadata_by_slot: list[dict[str | None, dict[str, Any]]],
) -> list[dict[str | None, float]] | None:
    ...
这两个 sampled session 会转换成以下 hook input:
[
    {"main": {"outcome": 1.0}, "searcher_0": {"usefulness": 0.6}},
    {"main": {"outcome": 0.0}, "searcher_0": {"usefulness": 0.2}},
]
返回值保持相同的外层顺序和 context name:
[
    {"main": 1.0, "searcher_0": 0.6},
    {"main": 0.0, "searcher_0": 0.0},
]该例中,main 使用任务 outcome,searcher_0 使用 outcome × usefulness。不同 context 可以使用不同的 metadata field 和 credit 公式。
输出第 i 项始终对应输入第 i 个 session;函数不能改变外层 list 顺序。一个 mapping 内通过 name 匹配 context, 因此 dict 展示顺序不重要。每个 exported name 都需要一个 numeric value,该值是整个 context 的训练 credit。 0.0 会保留该 context,并给它零 credit。返回顶层 None 会过滤完整 sampled Group,不会过滤单个 context。 隐式导出的单 context 使用 None 作为 context name。Eval 不调用该函数。
在 Custom Advantage 函数内完成 Normalization
Custom path 会跳过标准 GRPO reward normalization。标准 GRPO normalization 以每条 trajectory 的一个 scalar reward 为输入,无法表达 context role 或 turn-level credit structure。所有比较、centering、scaling 和 normalization 都必须在该函数内完成,包括 sampled Group 内不同 trajectory 之间、不同 context 或 role 之间, 以及 metadata 中 turn-level signal 的 normalization。当前函数为每个 exported context 返回一个 scalar,因此 turn-level signal 需要先归约成该 scalar。
--normalize-advantages 是后续独立的 whitening step,不能替代该函数内 role-aware 或 turn-aware 的 normalization。
Custom Advantage 之后的训练步骤
虽然参数名包含 advantage,函数返回的 scalar 是一个 context 的基础 credit。训练侧随后才会构造 token advantage,并应用 policy loss correction。该返回值不是最终 loss weight。
export metadata
→ custom advantage and task-specific normalization
→ one base scalar per exported context
→ returns and token advantages, with estimator-specific KL shaping when used
→ optional generic advantage whitening
→ policy ratio and estimator-specific clipping
→ OPSM, TIS, or other off-policy masks
→ entropy, independent KL, and optional distillation terms
→ loss reduction and backpropagation
KL 在后续训练中可能表示三种不同操作:
- Estimator 构造 return 时使用的 reference-policy KL;仅在该 estimator 支持 KL reward shaping 时生效;
- old-policy/current-policy log ratio,指标名为
ppo_kl,用于 policy clipping; - 通过
--use-kl-loss启用的独立 reference-policy KL loss。
Custom advantage 的 Reward 配置
一般不建议同时使用 --custom-rm-path 与 --agentic-custom-advantage-path。未启用 --group-rm 时,ordinary custom RM path 会被跳过。经过明确审查的 Group RM 仍可为指标或过滤写入 reward,训练 credit 由 custom advantage 提供。Advantage 函数使用的每项信号都应写入 export metadata。
Metrics 与 Passrate
reward为rollout/raw_reward和--log-passrate提供任务 outcome。- Reward object 中的 numeric helper field 使用
rollout/<field>/mean|median|max|min。 - Output metadata 的顶层 numeric field 使用
<field>/mean|median|max|min,不带rollout/前缀。 - Rollout dump 保留完整 metadata。
启用 --log-passrate 时,multi-context Session 使用显式导出,并且只有一个代表 context 携带 reward,通常是 main。选中的 primary reward value 成功时设为 1,其他情况设为 0;reward object 通过 --reward-key 选择该 值。Sibling context 不设置 reward。Custom advantage 需要同一 outcome 时,其他 context 可以在 metadata 中保存 该值。Group RM 如果为每个 exported row 写入 reward,则需要 custom logger 恢复 logical Session 分组。 Multi-context training 中,reward 用于上报 outcome,训练 credit 由 custom advantage 提供。
多 Context Dynamic Batching
任何可能从一个 session 导出多个 context 的 recipe 都必须配置 --agentic-custom-advantage-path,并且 必须启用 dynamic batching。一般不鼓励 custom RM;仅在经过明确审查后,将 Group RM 用于上报或过滤。
--use-dynamic-batch-size
--max-tokens-per-gpu <token-budget>
配置 Runtime 行为
必须满足的 external agent 容量
Agent 在带有硬并发限制的远程集中式平台运行时,先计算 train 上限和每个 Eval dataset 的上限:
T = agentic_concurrency * n_samples_per_prompt
G_d = dataset d 的 n_samples_per_eval_prompt
C_d = 显式配置的 agentic_eval_concurrency,未配置时为 ceil(T / G_d)
E_d = C_d * G_d
E_peak = 所有 Eval dataset 的 E_d 最大值
多个 Eval dataset 串行执行,因此组合峰值是 E_peak,无需把所有 E_d 相加。
启用 --agentic-prelaunch、--partial-rollout 或 --fully-async 时,表格中的 Eval 期间是否保留 train sessions 应选择“是”。Prelaunch 与当前 step 共享 training resident capacity, 因此 train 上限仍是 T;它会让 T 与 E_peak 同时存在。
Train 与 Eval 共用一个 executor 时,再选择对应场景:
| 是否启用 Eval | Eval 期间是否保留 train sessions | 所需 slots |
|---|---|---|
| 否 | — | external_slots >= T |
| 是 | 否 | external_slots >= max(T, E_peak) |
| 是 | 是 | external_slots >= T + E_peak |
Slots 不足时,Group 启动可能卡在 all-session first-request barrier。启动任务前必须检查该表格。
| 目标 | 参数 | 行为 |
|---|---|---|
| 限制 resident training Group | --agentic-concurrency | Prepare 与 Runtime 共享的 capacity |
| 设置 resident Eval Group | --agentic-eval-concurrency | 逻辑 Eval prompt Group capacity,未配置时根据 training capacity 推导 |
| 提前启动 agent | --agentic-prelaunch | Resident capacity 空闲时启动 process |
| 复用未完成 sample | --partial-rollout | 跨 step abort 并恢复 backend attempt |
| 异步执行 rollout 与 training | --fully-async | Partition 前进时保留未完成 session |
| 限制 partial abort 次数 | --partial-rollout-max-aborted-count | 保护多次被 abort 的 attempt |
| 终止运行过久的 agent | --agent-timeout | Runtime active-time budget 用尽后终止 agent process |
--agent-timeout 在 Session 进入 Runtime 后开始计时。Agent 的 loop、tool call 等持续运行过久时,Relax 会终止 该进程。Prelaunch Session 等待 Runtime 时不会消耗这段时间;partial rollout 或 fully async 让普通 Session 跨 step 暂停时,计时也会暂停。
--agentic-concurrency 默认使用 --over-sampling-batch-size,后者默认使用 --rollout-batch-size。 --agentic-eval-concurrency 未配置时,分别根据 T 和每个 Eval dataset 的 Group size 推导。两个参数都以逻辑 prompt Group 为单位。无论使用 ordinary RM 还是 Group RM,dataset d 都持有 E_d 个 Sessions;ordinary RM 内部使用 singleton Runtime Group,但不会改变该总数。多个 Eval dataset 串行执行,因此 Train 与 Eval 使用独立 executor 时,分别为 T 和 E_peak 配置容量。
Retriever、environment server 等 cross-session service 应在 per-session agent command 外启动。
Session KV lifecycle 与 program-aware admission 是长时间 Agentic workload 的可选能力。参见 Agentic KV Scheduling。
理解 Agentic Rollout 原理
Session Lifecycle
一个 dataset sample 创建一个 Session。Session 拥有一个 agent process、一个 SessionForest、rollout mode 和 active-time budget。Process 可以顺序或并发调用 model API。Process 退出后,Relax 选择指定 Forest state、计算训练 credit,并把 sample 发送到训练侧。
主要 runtime 路径是:
Prepare → Runtime → Reward → TransferSessionForest
SessionForest 保存每个 committed conversation state。不同 initial history、tools 或 template arguments 会形成不同 subtree。一个 subtree 可以包含多个 turn 和多个 branch。
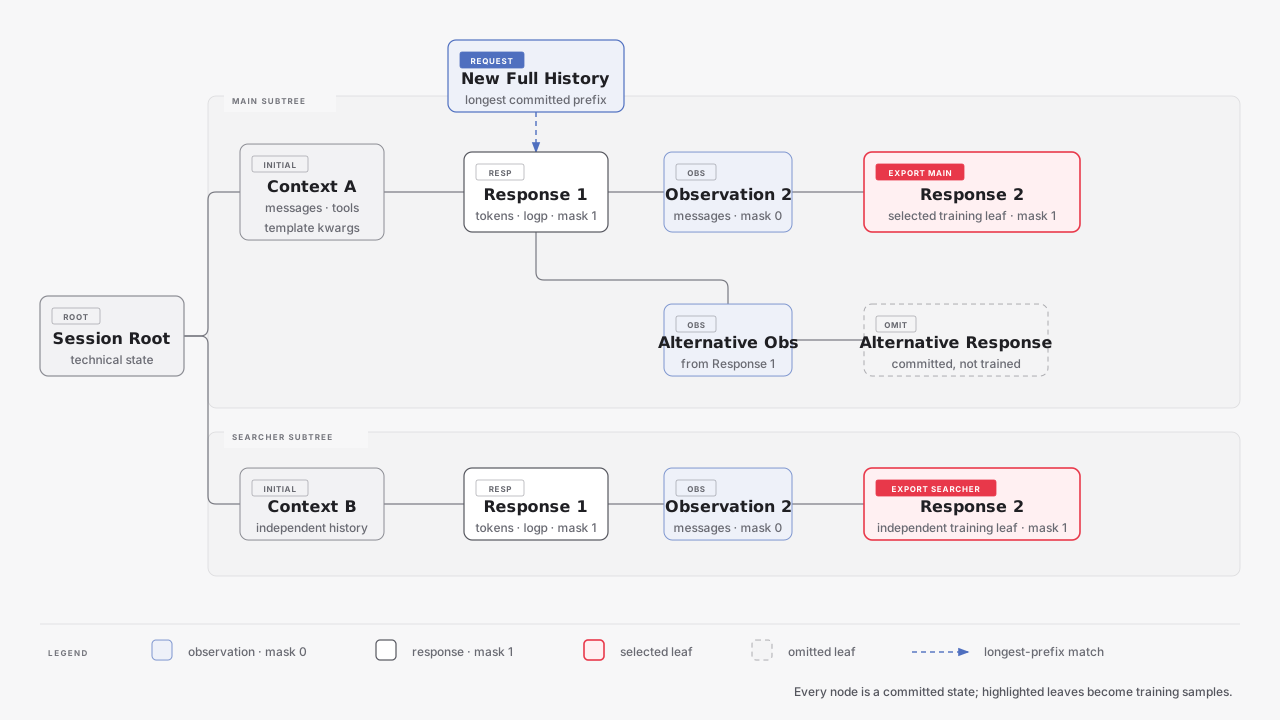
Observation node 保存新增的 system、user 或 tool message,loss mask 为 0。Response node 保存 generated token IDs、rollout logprobs 与可训练 loss mask。沿同一 normalized history 的多次 request 仍属于一个 context;history 分叉后形成不同 branch。最终导出的 leaf 决定训练 context。
State Identity 与 Prefix Matching
每种协议的 request 都携带完整 history,Relax 会先把它投影为 canonical messages。Relax 查找 tools 和 template arguments 相同的最长 committed message prefix。未匹配的 suffix 成为新的 observation。完整匹配会从已有 state 创建 branch;没有匹配时从 technical root 开始。
参考实现
@staticmethod
def _match_parent_state(
    *,
    forest: SessionForest,
    messages: list[dict[str, Any]],
    tools: list[dict[str, Any]],
    chat_template_kwargs: dict[str, Any],
) -> tuple[MsgNode, list[dict[str, Any]]]:
    for prefix_length in range(len(messages), 0, -1):
        prefix_hash = _messages_tools_template_state_hash(
            messages[:prefix_length],
            tools,
            chat_template_kwargs,
        )
        parent = forest.nodes_by_hash.get(prefix_hash)
        if parent is not None:
            return parent, messages[prefix_length:]
    root_state_hash = forest.root_state_hash
    assert root_state_hash is not None
    return forest.nodes_by_hash[root_state_hash], messages
Token 与 Sample 语义
Token-in, Token-out
Relax 把选中 lineage 的 inference token prefix 发给 SGLang,并把 SGLang 返回的 token IDs 原样追加到 inference 和 training response delta。Generated token、loss mask 与 rollout logprob 保持对齐,同时避免重新 tokenize response。
Text observation 的 inference 与 training 使用相同 tokenizer IDs。Multimodal observation 为 inference 保存 tokenizer IDs 与 media,同时为 training 保存 processor-expanded IDs 与 multimodal_train_inputs。Context limit 使用 processor 展开后的 training length。新增 media 归属当前 observation node,并沿 exported lineage 合并。
Observation-delta 与 multi-turn multimodal design 参考 One Rollout to Rule Them All: Seamless Multi-Turn RL for LLM and VLM。
从 Branch 构造 Training Sample
initial observation ─ response ─ observation ─ response
       prompt          loss=1       loss=0       loss=1
Relax 从 exported state 回溯到 root,并拼接已记录的 delta。Initial observation 构成 prompt。后续 observation 保留在 continuation 中,loss mask 为 0。Model response 使用可训练 mask 和对齐的 rollout logprob。Exported lineage 至少包含一个 committed response。
Runtime Scheduling
Resident Capacity
Prepare 与 Runtime 共享 resident Group capacity。Reward work 位于该 capacity 外。Runtime Group 完成或 drop 后 会释放 slot。Group 被 filter 后会产生新的需求。
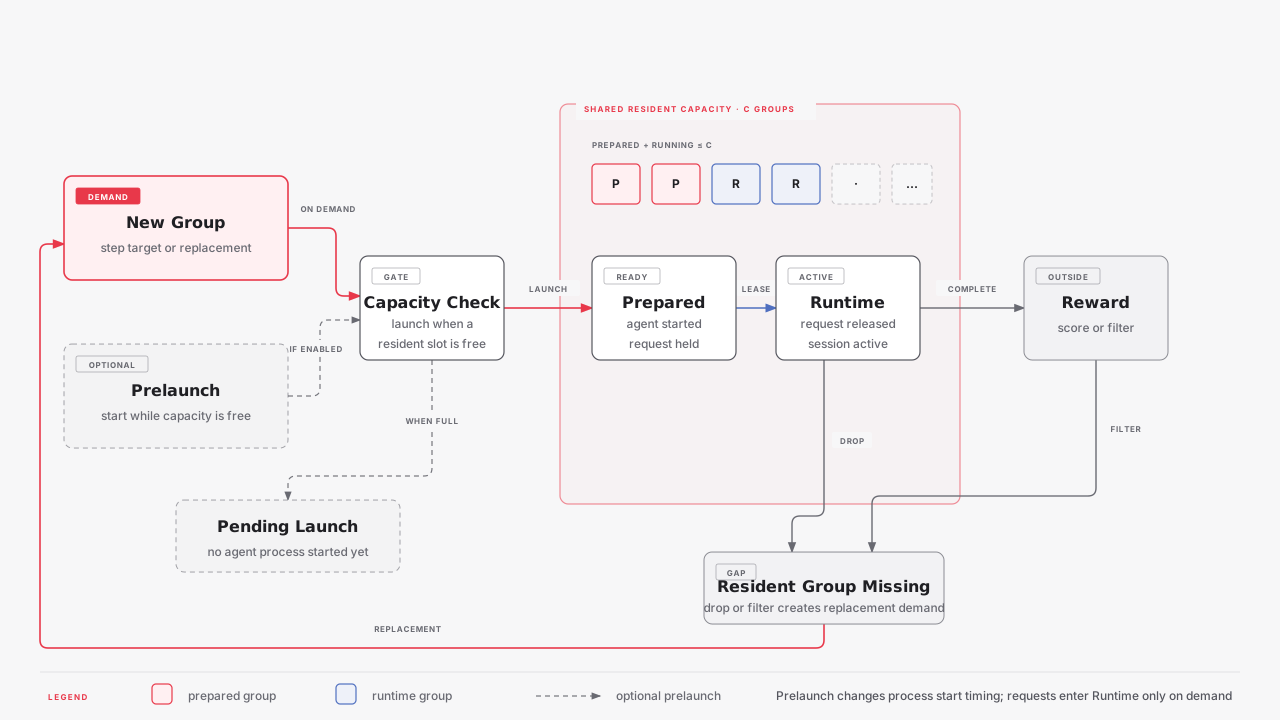
Prelaunch
Prelaunch 改变 agent process 的启动时间,不改变 request 进入 Runtime 的时间。启用 prelaunch 后,agent 可以提前 发送第一条 request;Relax 会持有该 request,直到 Group 获得 Runtime lease。
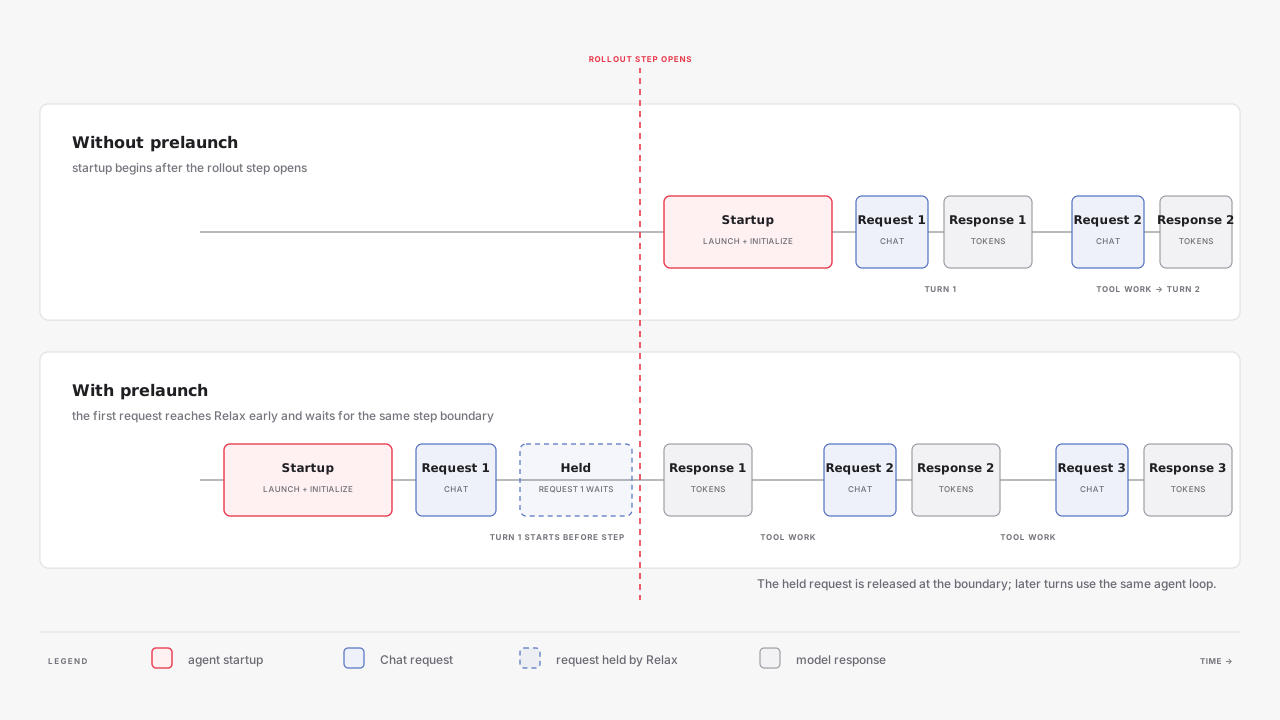
跨 Step 留存
Partial rollout 与 fully async 都可以跨 rollout step 保留 Session。下图展示 partial rollout 路径:SGLang 在 abort 后返回 partial token prefix,Relax 暂停 request,后续 backend attempt 继续同一个 HTTP request。
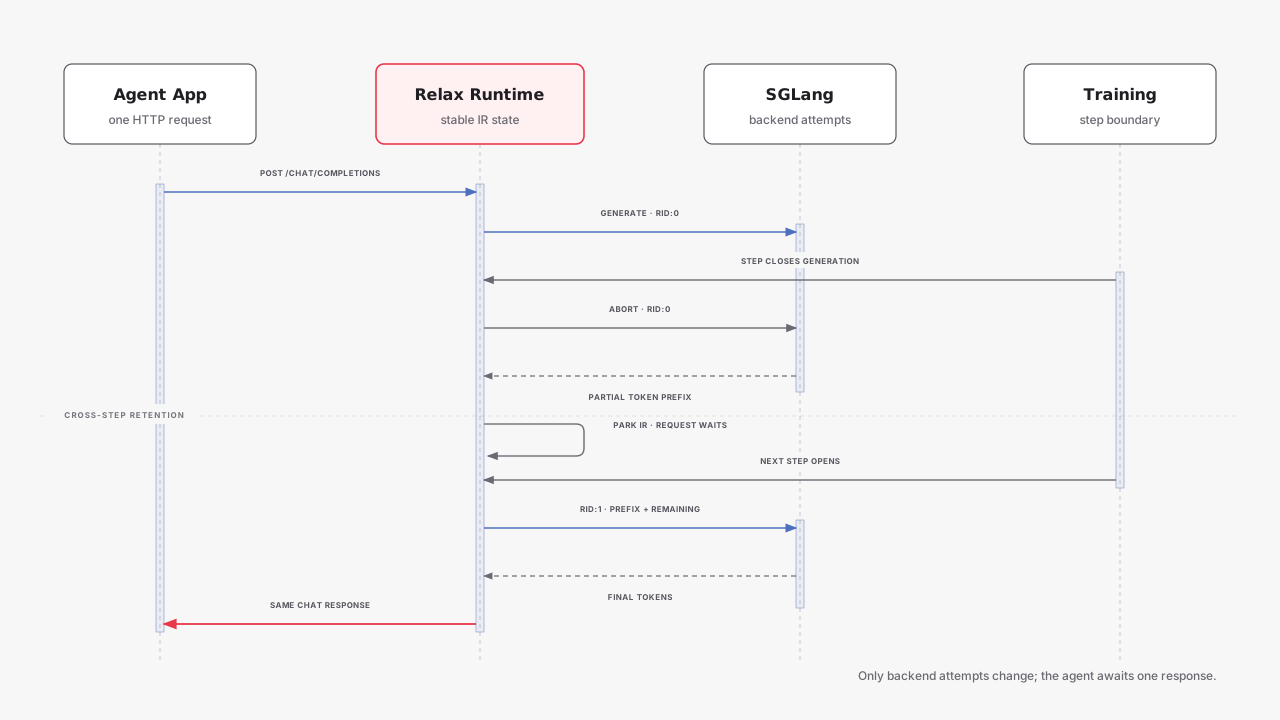
Fully async 留存不要求每个 session 都经过同一套 abort/resume 时序。Partition 与 backfill 行为参见 Fully Async Training。
KV Scheduling
Program-aware admission 可以根据预测的 KV 使用量延迟 backend attempt。Session lifecycle 可以在 session 结束时 释放 Session radix-cache entry。参见 Agentic KV Scheduling。
运维与故障排除
Metrics 与 Dump
配置 --save-debug-rollout-data <path-with-{rollout_id}>,可保存完整 metadata、SessionForest state hash、terminal status、turn count、request timing、abort count 与 weight-version 信息。
常见问题
- Agent 没有启动或异常退出: 检查
--agent-cwd和--agent-command,然后查看run.log。Relax 会把 agent stdout 与 stderr 的末尾内容附加到AgentExecutionError。 - 第一条 request 长时间等待: Group 获得 Runtime lease 前,request 会保持等待;client 应配置长 timeout。
- 显式导出无法匹配: 保留 generation 实际使用的完整 normalized
messages、tools和chat_template_kwargs。 - 隐式导出无法唯一确定 context: 为需要训练的 context 写入具名显式 record。
- 多轮后 context length 失败: 减少 observation size、completion length 或 turn 数;limit 使用完整的 processor-expanded training lineage。
示例与下一步
examples/search_r1/:text-agent 与 multi-agent training。examples/deepeyes_agentic/:multimodal tool-use training。examples/mini_swe_agent/:external agent server 与 sandboxed coding task。- Fully Async Training:异步 rollout 与 training。
- Dataset Design:dataset input 与 metadata。